GPTBot, OAI-SearchBot, ClaudeBot : quels robots d’IA laisser entrer sur votre site
Bloquer « les robots d’IA » d’un bloc est une erreur fréquente : on bloque aussi ceux qui permettent d’être cité. Voici ce que fait chaque robot, ce que coûte un blocage, et un robots.txt de départ.
Publié le 7 min de lecture
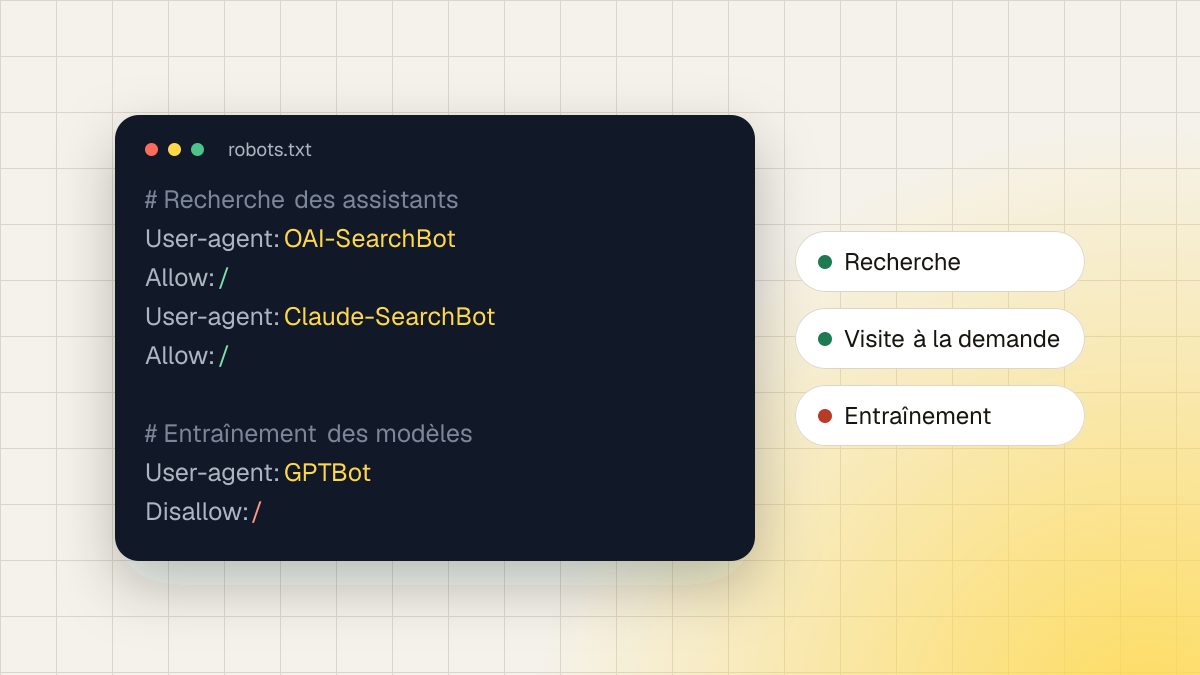
Quand on parle des robots des IA, on imagine un seul visiteur qui aspire le web pour entraîner des modèles. En réalité, chaque éditeur en utilise plusieurs, avec des rôles différents. Certains servent à l’entraînement. D’autres servent à la recherche : ce sont eux qui permettent à ChatGPT, Claude ou Perplexity de citer votre site dans une réponse.
Bloquer tout le monde « par précaution » revient donc souvent à disparaître des réponses que vous cherchez à obtenir. Voici comment faire le tri.
Trois rôles à ne pas confondre
Les documentations officielles distinguent trois usages.
- L’entraînement : le robot collecte des pages qui pourront servir à entraîner les futurs modèles.
- La recherche : le robot explore le web pour que l’assistant puisse trouver, citer et lier des pages dans ses réponses.
- La visite à la demande : un utilisateur demande à l’assistant de consulter une page, et un agent va la lire à sa place.
Le tableau ci-dessous reprend les robots déclarés par les principaux éditeurs, avec ce qu’en disent leurs documentations.
| Robot | Éditeur | Rôle | Respecte robots.txt |
|---|---|---|---|
| GPTBot | OpenAI | Entraînement | Oui |
| OAI-SearchBot | OpenAI | Recherche dans ChatGPT | Oui |
| ChatGPT-User | OpenAI | Visite à la demande | Non, selon OpenAI |
| ClaudeBot | Anthropic | Entraînement | Oui |
| Claude-SearchBot | Anthropic | Recherche | Oui |
| Claude-User | Anthropic | Visite à la demande | Oui |
| PerplexityBot | Perplexity | Recherche (pas d’entraînement) | Oui |
| Perplexity-User | Perplexity | Visite à la demande | En général non, selon Perplexity |
| Google-Extended | Entraînement et ancrage de Gemini | Oui (ce n’est pas un robot distinct) |
Sources : OpenAI, Anthropic, Perplexity, Google.
Deux cas méritent une explication.
Google-Extended n’est pas un robot. C’est un mot-clé que l’on place dans robots.txt. L’exploration est faite par les robots habituels de Google ; Google-Extended indique seulement si le contenu peut servir à entraîner les modèles Gemini et à ancrer les réponses de Gemini Apps et de Vertex AI. Google précise qu’il n’a aucun effet sur la présence d’un site dans la recherche Google, ni sur son classement.
Les visites à la demande échappent en partie à robots.txt. OpenAI indique que ChatGPT-User n’est pas concerné par robots.txt, puisque la visite est demandée par une personne. Perplexity dit la même chose de Perplexity-User. Anthropic, à l’inverse, indique que Claude-User respecte robots.txt.
Ce que coûte chaque blocage
C’est la question qui compte : que perdez-vous en bloquant tel robot ?
- Bloquer OAI-SearchBot : votre site n’apparaît plus dans les réponses de recherche de ChatGPT. OpenAI l’écrit explicitement.
- Bloquer GPTBot : vos pages ne servent plus à l’entraînement des modèles d’OpenAI. D’après OpenAI, cela n’a pas d’effet sur votre présence dans la recherche de ChatGPT. Les deux réglages sont indépendants.
- Bloquer Claude-SearchBot : Anthropic indique que cela réduit la visibilité et la justesse de votre site dans les résultats de recherche de Claude.
- Bloquer Claude-User : Claude ne peut plus lire votre page quand un utilisateur le lui demande.
- Bloquer PerplexityBot : vous vous retirez des résultats de Perplexity.
- Bloquer Google-Extended : aucun effet sur la recherche Google, d’après Google. Les AI Overviews et AI Mode, eux, dépendent de l’indexation classique : pour en sortir, il faudrait utiliser des directives comme
nosnippetounoindex, qui touchent aussi vos résultats ordinaires (Google Search Central).
Autrement dit : pour une marque qui veut être citée, les robots de recherche doivent passer. La question de l’entraînement est un choix, qui ne dépend pas de votre visibilité dans les réponses de recherche.
Un robots.txt de départ
Voici une base pour une marque qui veut être citée par les assistants, en gardant la main sur l’entraînement. Les lignes d’entraînement sont à adapter : un média qui vend ses articles n’a pas les mêmes intérêts qu’une marque qui cherche à se faire connaître.
# Recherche des assistants IA : autorisée.
# C'est ce qui leur permet de citer et de lier vos pages.
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Visites demandées par un utilisateur : autorisées.
User-agent: Claude-User
Allow: /

# Entraînement des modèles : votre choix.
# Remplacez Disallow par Allow si vous souhaitez y participer.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Trois précautions avant de publier ce fichier.
- Relisez vos règles existantes. Selon la norme de robots.txt (RFC 9309), un robot suit uniquement le groupe qui porte son nom, et le groupe
User-agent: *seulement s’il n’en trouve aucun. Deux conséquences : les restrictions générales ne s’appliquent plus à un robot nommé, et un robot que vous n’avez pas nommé suit le groupe*. - Laissez le temps aux changements. OpenAI indique qu’il faut environ 24 heures pour que ses systèmes tiennent compte d’une modification de robots.txt.
- Vérifiez votre pare-feu et votre CDN. robots.txt n’est qu’une consigne ; un pare-feu peut bloquer un robot avant même qu’il ne la lise. Cloudflare, par exemple, a annoncé en juillet 2025 changer ses réglages par défaut pour bloquer les robots d’IA, puis a introduit des réglages par catégorie. Pour les nouveaux domaines, depuis le 15 septembre 2026, l’entraînement et les agents sont bloqués par défaut sur les pages qui affichent de la publicité, tandis que la recherche reste autorisée (Cloudflare). Allez voir ce qui est réellement réglé sur votre compte.
Vérifier ce qui passe vraiment : vos journaux serveur
robots.txt dit ce que vous demandez. Les journaux de votre serveur disent ce qui se passe. Chaque visite y est inscrite avec son agent utilisateur (user agent), c’est-à-dire le nom sous lequel le robot se présente.
Sur un serveur classique, une commande suffit pour compter les visites de chaque robot d’IA :
grep -oE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User" access.log | sort | uniq -c | sort -rnCe que vous cherchez :
- Aucune visite d’un robot de recherche alors que vous l’autorisez : vérifiez le pare-feu, le CDN et les codes de réponse (403, 429) renvoyés à ce robot.
- Des visites à la demande (ChatGPT-User, Claude-User, Perplexity-User) : c’est le signe que des utilisateurs font lire vos pages par leur assistant. Regardez lesquelles : elles vous disent ce que les gens cherchent à vérifier avant de vous choisir.
- Des pages très visitées par les robots et absentes des réponses : la page est lue, mais elle ne répond pas assez directement aux questions posées.
Un nom d’agent peut être usurpé. Anthropic publie une liste d’adresses IP pour vérifier que ses robots sont bien les siens ; quand un éditeur publie ce type de liste, servez-vous-en avant de tirer des conclusions.
Et ensuite
Un robots.txt bien réglé est une condition, pas une garantie. Il permet aux assistants de lire votre site ; il ne dit pas s’ils vous citent. Pour le savoir, il faut poser les questions de vos clients aux assistants et compter les réponses : c’est l’objet de notre article sur les indicateurs de visibilité IA, et de la méthodologie de Vizioa.
Pour comprendre pourquoi un réglage peut vous rendre visible dans un assistant et pas dans un autre, lisez aussi pourquoi votre marque n’a pas la même visibilité partout.
Questions fréquentes
Bloquer GPTBot fait-il disparaître mon site de ChatGPT ?
Non. D’après OpenAI, GPTBot sert à l’entraînement. L’apparition dans les réponses de recherche de ChatGPT dépend d’OAI-SearchBot. Les deux réglages sont indépendants.
Google-Extended me retire-t-il des AI Overviews ?
Non. Selon Google, Google-Extended n’a aucun effet sur la présence dans la recherche Google. Les AI Overviews s’appuient sur l’indexation classique ; seules des directives comme nosnippet ou noindex agissent sur elles, et elles touchent aussi les résultats ordinaires.
Faut-il un fichier llms.txt pour être cité ?
Pour Google, non : sa documentation indique qu’aucun fichier ni balisage spécial n’est nécessaire pour apparaître dans les AI Overviews et AI Mode. llms.txt est une proposition de format publiée en 2024 (llmstxt.org), pas une règle que tous les assistants appliquent. Il ne remplace en aucun cas un robots.txt qui laisse passer les robots de recherche.
Sources
- OpenAI, Overview of OpenAI Crawlers, consultée le 29 septembre 2026.
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?, consultée le 29 septembre 2026.
- Perplexity, Perplexity Crawlers, consultée le 29 septembre 2026.
- Google, List of Google’s common crawlers, consultée le 29 septembre 2026.
- Google Search Central, AI features and your website, page mise à jour le 10 décembre 2025.
- IETF, RFC 9309 : Robots Exclusion Protocol, septembre 2022.
- Jeremy Howard, The /llms.txt file, proposition publiée le 3 septembre 2024.
- Cloudflare, Content Independence Day: no AI crawl without compensation!, 1er juillet 2025.
- Cloudflare, Your site, your rules: new AI traffic options for all customers, 1er juillet 2026.
À propos de l’auteur
Fondateur de Modernova Studio, expert GEO
Mouad Rifi a fondé Modernova Studio, l’éditeur de Vizioa. Il travaille sur la visibilité des marques dans les réponses des assistants IA : ce que ChatGPT, Gemini, Perplexity ou Google AI Overviews disent d’une entreprise, et comment le mesurer.