Audit GEO : la méthode en 6 étapes pour mesurer votre visibilité dans les IA
Un audit GEO mesure si les assistants IA mentionnent votre marque et citent votre site. La méthode en 6 étapes, un vrai audit anonymisé de 54 réponses, et l’étape que la plupart des guides oublient : la marge d’erreur.
Publié le 15 min de lecture
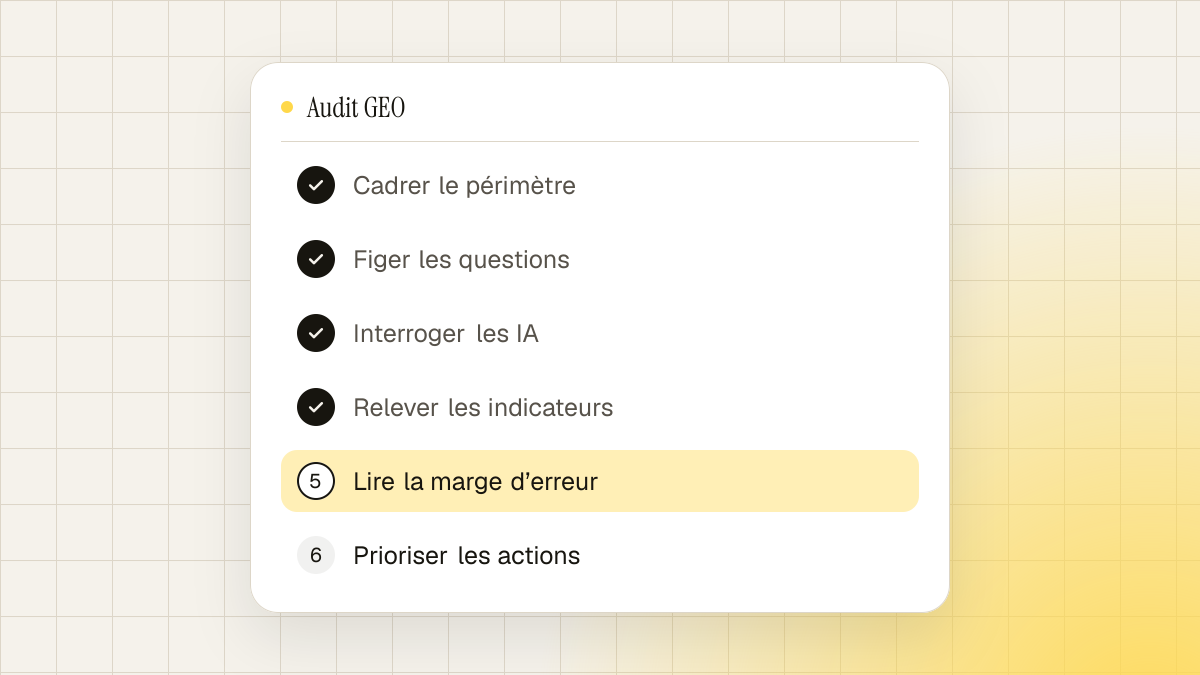
Un audit GEO mesure si les assistants IA (ChatGPT, Gemini, Perplexity, Claude, Google AI Overviews) mentionnent votre marque et citent votre site. Il repose sur un panel fixe de questions, posées plusieurs fois à chaque IA. Il se termine par un plan d’actions priorisé, pas par un score.
Cet audit se fait en 6 étapes : cadrer, choisir les questions, interroger, relever les indicateurs, lire la marge d’erreur, prioriser. Comptez une demi-journée pour une première version manuelle. La plupart des guides s’arrêtent à l’étape 4. C’est l’étape 5 qui évite de vendre du bruit à un client.
Pour l’illustrer, cet article s’appuie sur un vrai audit Vizioa, anonymisé : un cabinet de conseil, 54 réponses de ChatGPT et Claude. Sa présence globale est de 43 %. Sur les questions qui ne nomment pas la marque, elle tombe à 14 %.
Qu’est-ce qu’un audit GEO (et qu’est-ce que ce n’est pas) ?
Le GEO (Generative Engine Optimization) désigne l’optimisation de votre présence dans les réponses des moteurs génératifs. Un audit GEO en est la photo de départ. Il répond à une question simple : quand un client pose sa question à une IA, votre marque apparaît-elle, à côté de quels concurrents, et sur quelles sources l’IA s’appuie-t-elle ?
Ce n’est pas un audit SEO. Un audit SEO vérifie l’indexation, la technique, le contenu et les liens. Un audit GEO observe la réponse générée. Les deux se complètent : vous pouvez être bien classé sur Google et absent des réponses d’un assistant.
Ce n’est pas non plus une série de captures d’écran. Une capture montre un cas. Un audit doit montrer une tendance.
Pourquoi faire un audit GEO maintenant ?
Trois faits, sourcés, suffisent à cadrer l’enjeu.
- Le clic recule quand un résumé IA apparaît. Selon une étude du Pew Research Center portant sur 68 879 recherches Google, les internautes cliquent sur un lien classique dans 8 % des visites avec résumé IA, contre 15 % sans. Ils cliquent sur une source citée dans le résumé dans 1 % des visites (Pew Research Center, juillet 2025). Il s’agit de 900 adultes américains, sur Google uniquement, en mars 2025.
- Les réponses varient à chaque question. SparkToro et Gumshoe.ai ont fait poser 12 questions à ChatGPT, Claude et aux IA de Google par 600 volontaires, soit 2 961 exécutions. Interrogés 100 fois, ChatGPT ou l’IA de Google ont moins d’une chance sur 100 de donner deux fois la même liste de marques (SparkToro, janvier 2026).
- Le SEO reste le socle. Pour apparaître dans les AI Overviews et AI Mode, Google indique qu’une page doit être indexée et éligible à un extrait, et qu’il n’y a pas d’exigence technique supplémentaire (Google Search Central).
La conséquence pratique : on ne juge pas une visibilité IA sur une réponse. On la juge sur un taux, mesuré sur beaucoup de réponses.
Comment faire un audit GEO : 6 étapes
Étape 1. Cadrer le périmètre de l’audit
Décidez de ce que vous auditez avant de tester quoi que ce soit.
- Une marque, un produit ou une offre. Pas tout à la fois.
- Deux à trois concurrents directs. Sans eux, un taux de présence ne veut rien dire.
- Un pays et une langue. Les réponses changent avec les deux.
- Trois à quatre moteurs. ChatGPT, Perplexity et Google AI Overviews couvrent un premier audit. Ajoutez Gemini, Claude ou Copilot si votre cible B2B les utilise.
Ne mélangez pas les moteurs dans un seul chiffre. Chacun a ses sources et ses habitudes : lisez-les séparément. Nous expliquons pourquoi dans notre article sur les écarts entre assistants.
Étape 2. Construire le panel de questions
Le panel est le cœur de l’audit. Un mauvais panel donne un mauvais diagnostic.
Écrivez des questions telles que vos clients les poseraient, pas des mots-clés SEO déguisés. Répartissez-les par intention.
| Intention | Exemple pour une agence SEO |
|---|---|
| Catégorie | « Quelle agence choisir pour se faire recommander par ChatGPT ? » |
| Comparatif | « Agence A ou agence B pour un audit GEO ? » |
| Problème | « Pourquoi mes concurrents sont-ils cités par l’IA et pas moi ? » |
| Méthode | « Comment mesurer sa visibilité dans Perplexity ? » |
| Marque | « Que pensez-vous de [votre marque] ? » |
Combien de questions ? Les guides francophones donnent des fourchettes larges : 10 à 15 requêtes pour un panel initial selon Cicero Studio, 30 à 80 pour un panel utile selon Geoptim. Pour démarrer, visez 20 à 30 questions. Puis figez-les : si le panel change à chaque mesure, vous ne mesurez plus une évolution.
Étape 3. Interroger les IA proprement
Trois règles évitent l’essentiel des erreurs.
- Posez chaque question plusieurs fois. Trois passes par question et par moteur est un minimum raisonnable. C’est le choix par défaut de la méthodologie Vizioa.
- Interrogez sans compte connecté, en navigation privée. Un compte connecté personnalise la réponse (historique, mémoire, localisation).
- Notez la date et le moteur pour chaque réponse. Les modèles changent. Une variation sur trois mois peut venir du modèle, pas de vous.
Prenez aussi 10 minutes pour vérifier l’accès de base. Google rappelle de s’assurer que l’exploration est autorisée dans le fichier robots.txt et sur le CDN (Google Search Central). Contrôlez aussi que votre robots.txt ne bloque pas les robots de recherche des IA, comme OAI-SearchBot pour ChatGPT (OpenAI) ou PerplexityBot pour Perplexity (Perplexity). Le détail robot par robot est dans notre guide des robots des IA.
Étape 4. Relever les indicateurs (mention, citation, part de voix)
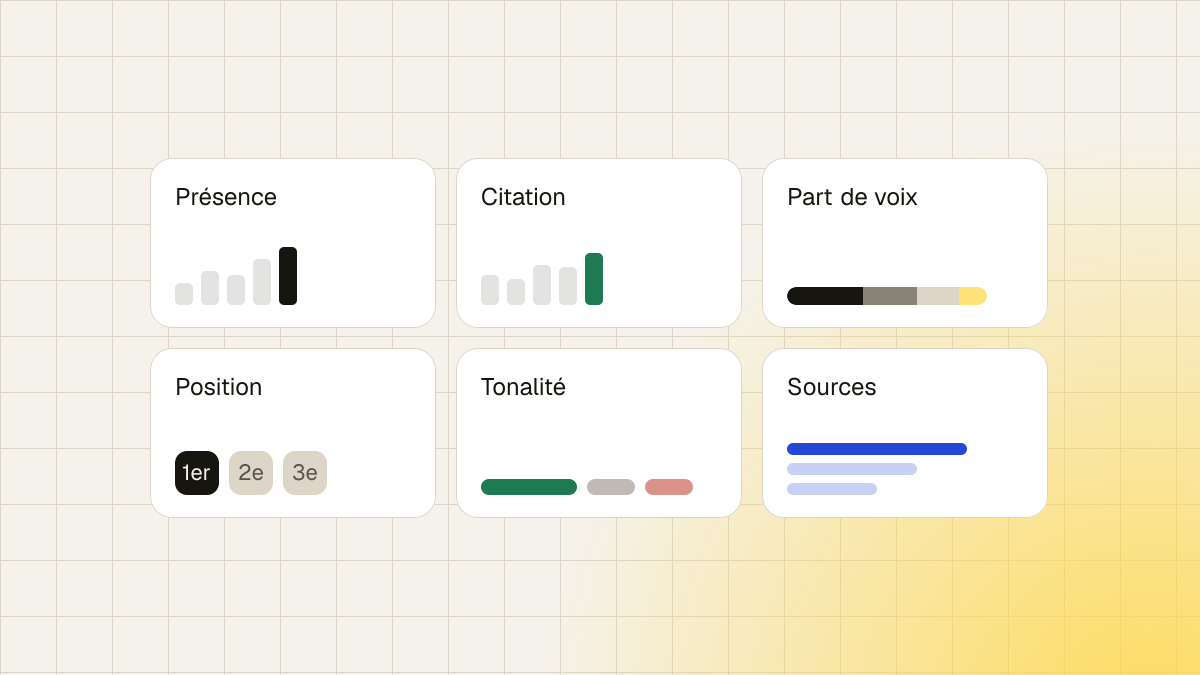
Pour chaque réponse, relevez cinq choses.
- Mention : votre nom apparaît-il dans le texte ?
- Citation : une URL de votre site figure-t-elle dans les sources ?
- Part de voix : combien de marques suivies apparaissent, et qui prend votre place ?
- Exactitude : prix, offre, zone, catégorie. Y a-t-il une erreur ?
- Sources : quels sites l’IA cite-t-elle (comparateurs, médias, annuaires, forums, concurrents) ?
Séparez mention et citation. Vous pouvez être nommé sans être cité, ou cité sans être nommé. Ce ne sont pas les mêmes problèmes, donc pas les mêmes actions. Nous détaillons ces indicateurs dans Mesurer sa visibilité dans les IA : 6 indicateurs.
Et ne suivez pas la position d’une marque dans une liste comme un rang Google. SparkToro a observé que l’ordre des marques change presque à chaque exécution : il faudrait de l’ordre de 1 000 exécutions pour voir deux listes dans le même ordre.
Étape 5. Lire les résultats : la marge d’erreur
C’est l’étape que les autres guides oublient. Un taux de présence est une estimation. Il a une marge d’erreur, qui dépend du nombre de réponses. Ne l’ignorez pas.
Voici d’abord un calcul d’illustration : des chiffres inventés pour montrer l’effet de l’effectif, pas un résultat d’audit. Intervalle de confiance à 95 %, méthode de Wilson, adaptée aux petits échantillons. Les chiffres d’un audit réel suivent plus bas.
| Situation | Réponses avec mention | Taux | Intervalle à 95 % |
|---|---|---|---|
| Avant, 12 questions × 3 passes, 1 moteur | 12 sur 36 | 33 % | 20 % à 50 % |
| Après, mêmes conditions | 18 sur 36 | 50 % | 34 % à 66 % |
| Avant, 10 fois plus de réponses | 120 sur 360 | 33 % | 29 % à 38 % |
| Après, 10 fois plus de réponses | 180 sur 360 | 50 % | 45 % à 55 % |
Lecture. Sur 36 réponses, le passage de 33 % à 50 % ne prouve rien : les deux intervalles se chevauchent. Sur 360 réponses, le même écart est net : les intervalles sont séparés.
Deux règles à retenir.
- Ne présentez pas une hausse sans dire sur combien de réponses elle repose. « De 33 à 50 % » n’a pas de sens sans l’effectif.
- Restez prudent sur les passes. Poser trois fois la même question ne donne pas trois observations indépendantes. L’intervalle réel est donc probablement plus large que celui du tableau. Multipliez les questions, pas seulement les passes.
Même logique côté corrélation : une hausse après une action ne prouve pas que l’action en est la cause. Les modèles et vos concurrents évoluent en même temps.
Étape 6. Prioriser et livrer un plan d’actions
Le vrai livrable d’un audit GEO, c’est la liste des décisions. Classez chaque constat par priorité et par effort.
- Les questions business où vous êtes absent. Ce sont celles où un client choisit un prestataire ou un outil.
- Les erreurs de description. Une information fausse pèse plus qu’une absence. Corrigez d’abord vos pages, puis les sources tierces que vous maîtrisez.
- Les pages déjà citées sans que la marque soit nommée. Le gain est rapide : reliez mieux la page à l’offre et à la marque.
- Les contenus manquants. Une page comparative, une page de méthode, une page de service claire.
- Les sources tierces très citées. Si un comparatif domine les réponses et ne vous mentionne pas, l’y faire figurer vaut souvent plus qu’un nouvel article sur votre site.
Pour chaque action, notez le constat qui la justifie. Sans constat, pas d’action.
Exemple d’audit Vizioa : ce que les chiffres disent (et ne disent pas)
Voici un cas réel, anonymisé. Audit réalisé avec Vizioa le 18 septembre 2026 pour un cabinet de conseil.
- Périmètre : 9 questions, 2 moteurs (ChatGPT et Claude), 3 passes par question, soit 54 réponses.
- Méthode : réponses obtenues par API avec recherche web, sans historique ni personnalisation.
- Score : 52 sur 100.
Les résultats du rapport, avec l’intervalle de confiance à 95 % que nous avons calculé (Wilson, z = 1,96) :
| Indicateur | Taux | Effectif | Intervalle à 95 % |
|---|---|---|---|
| Présence globale | 43 % | 23 sur 54 | 30 % à 56 % |
| Présence spontanée (6 questions sans le nom de la marque) | 14 % | 5 sur 36 | 6 % à 29 % |
| ChatGPT | 37 % | 10 sur 27 | 22 % à 56 % |
| Claude | 48 % | 13 sur 27 | 31 % à 66 % |
| Site cité en source | 39 % | 21 sur 54 | 27 % à 52 % |
Les effectifs de la ligne « présence spontanée » sont recomptés à partir du détail par question : 6 questions × 2 moteurs × 3 passes = 36 réponses, dont 5 citent la marque. Cela redonne bien 14 %.
Ce que l’écart entre ChatGPT et Claude ne prouve pas
Claude cite la marque dans 48 % des réponses, ChatGPT dans 37 %. L’écart paraît net. Il ne l’est pas : les intervalles (22 à 56 % contre 31 à 66 %) se recouvrent presque entièrement. Un test exact de Fisher, que nous avons calculé sur les mêmes effectifs, donne p ≈ 0,58. Sur ces données, on ne peut pas dire qu’un moteur est plus favorable que l’autre.
Un point de prudence de plus : les 3 passes d’une même question ne sont pas indépendantes. Elles interrogent le même moteur sur la même formulation. L’effectif utile peut donc être plus proche du nombre de questions (9, ou 6 sans le nom) que de 54 (ou 36). Les intervalles ci-dessus sont probablement trop étroits.
Leçon 1. Séparez présence globale et présence spontanée
Trois questions sur 9 nomment la marque (un comparatif, deux questions « marque »). Sur ces 18 réponses, la marque apparaît 18 fois, soit 100 %. C’est logique : on lui a posé la question.
Sur les 6 autres questions, elle apparaît dans 5 réponses sur 36, soit 14 % (intervalle : 6 à 29 %). Autrement dit, 18 des 23 réponses positives viennent de questions qui nomment la marque. Le 43 % global mélange deux situations : un prospect qui connaît le cabinet, et un prospect qui ne le connaît pas.
Les 5 réponses spontanées sont en plus très concentrées : 4 viennent d’une seule question de type catégorie, et 4 sur 5 viennent de Claude.
À retenir : affichez toujours les deux chiffres, et dites combien de questions nomment la marque. Le mélange du panel change aussi le score global.
Leçon 2. Lisez par type de question
Le rapport découpe la présence par type de question.
| Type | Questions | Réponses | Présence | Intervalle à 95 % |
|---|---|---|---|---|
| Comparatif et marque | 3 | 18 | 100 % | 82 % à 100 % |
| Catégorie | 3 | 18 | 28 % (5 sur 18) | 12 % à 51 % |
| Problème | 2 | 12 | 0 % | 0 % à 24 % |
| Local | 1 | 6 | 0 % | 0 % à 39 % |
Quatre questions sur 9 n’ont donné aucune réponse citant la marque. Ce sont des questions où un prospect décrit son besoin sans nommer de cabinet.
Attention à la lecture d’un 0 %. Sur 6 réponses, un taux de 0 % est compatible avec un taux réel allant jusqu’à 39 %. C’est un signal pour creuser, pas une preuve d’invisibilité totale. Ajoutez des questions dans ce type avant de conclure.
Leçon 3. Lisez les sources, pas seulement la marque
Le rapport recense 296 citations, réparties par type de site.
| Type de source | Part des citations |
|---|---|
| Sites d’entreprises | 39 % |
| Institutions | 32 % |
| Site de la marque | 16 % (46 citations) |
| Concurrents | 8 % |
| Réseaux et forums | 3 % |
| Presse et médias | 1 % |
| Annuaires et comparateurs | 0 % |
Trois domaines institutionnels figurent parmi les plus cités, et le site de la marque se place juste derrière le premier d’entre eux.
Dans cet échantillon, les IA vont donc chercher leurs réponses sur des sites d’entreprises et des sites institutionnels. Annuaires, comparateurs et presse y pèsent peu. Chaque secteur a sa propre répartition : refaites la lecture pour chaque client.
Le rapport liste aussi les « places à prendre » : des sources citées dans des réponses qui nomment un concurrent sans nommer la marque. Il y en a six, chacune sur 2 ou 3 réponses seulement : quatre sites de cabinets concurrents et deux sites institutionnels. Avec des effectifs aussi faibles, ce sont des pistes à vérifier, pas un classement.
Ce que cet exemple ne dit pas
- Il n’explique pas pourquoi la marque est absente sur certaines questions. Il montre où les IA vont chercher, pas ce qui a déterminé leur choix. Une hausse ou une baisse ultérieure ne prouverait pas non plus l’effet d’une action.
- Il repose sur peu de données : 54 réponses, 2 moteurs, 9 questions, une seule date. Les modèles et les sources bougent. Une seconde mesure dira plus qu’une première.
- Il est directionnel : réponses par API, sans compte connecté, différentes de l’écran d’un utilisateur personnalisé.
Modèle de tableau d’audit GEO
Un tableur suffit pour commencer. Une ligne par réponse.
| Colonne | Contenu |
|---|---|
| Question | Texte figé du panel |
| Intention | Catégorie, comparatif, problème, méthode, marque |
| Moteur et date | ChatGPT, 29/09/2026… |
| Passe | 1, 2 ou 3 |
| Mention | Oui ou non |
| Citation | Oui ou non |
| Marques citées | Vous et vos concurrents |
| Sources | Domaines listés |
| Exactitude | Correcte, ou erreur (à préciser) |
| Action liée | Contenu, technique, source tierce, avis |
Calculez ensuite le taux de mention et le taux de citation par moteur, puis par intention. Un taux global masque les écarts.
Audit GEO manuel ou avec un outil ?
Le manuel suffit pour un premier audit sur une marque : 20 questions, 3 passes, 2 moteurs, c’est déjà 120 réponses à lire et à consigner. Il devient lourd dès que vous ajoutez des moteurs, des concurrents ou une répétition mensuelle.
C’est là qu’un outil aide, sans rien changer à la méthode. Vizioa pose chaque question à sept assistants (ChatGPT, Claude, Perplexity, Gemini, Google AI Overviews, Google AI Mode, Microsoft Copilot), sans compte utilisateur. Un audit de prospect tourne en moins de 10 minutes, avec 3 passes par défaut. Les résultats sont présentés en taux de présence, part de voix et sources citées. Les limites sont publiées : les chiffres sont directionnels, et sur peu de questions un écart de quelques points n’est pas significatif (méthodologie). Un outil ne remplace pas l’étape 5 : lisez toujours l’effectif derrière le pourcentage.
Audit GEO pour agence : comment le transformer en mission
Pour une agence, l’audit est une porte d’entrée : il montre au client ce que les IA disent de lui, et de ses concurrents. Trois conseils.
- Ouvrez par les décisions, pas par les données : où le client est présent, où il est absent, ce qu’il faut corriger en premier.
- Montrez quelques réponses parlantes, pas cent captures : une question business où un concurrent est nommé, une erreur de description, une source dominante qui l’ignore.
- Ne promettez jamais une citation. Aucun prestataire ne contrôle les moteurs. Promettez une méthode, une mesure et un plan.
Vizioa propose une offre agences : 3 audits gratuits par mois, un rapport à votre logo et une proposition d’actions sans prix, à laquelle vous ajoutez votre devis. Les détails sont sur la page des tarifs.
Les erreurs qui faussent un audit GEO
- Tester trois questions et conclure. C’est une impression, pas un audit.
- Changer les questions d’une mesure à l’autre.
- Ne regarder que ChatGPT.
- Confondre mention et citation.
- Comparer deux pourcentages sans effectif.
- Oublier les sources. Ce sont elles qui disent où agir.
Conclusion
Un bon audit GEO est sobre : un panel figé, plusieurs passes, des indicateurs séparés, un effectif toujours affiché, et un plan d’actions classé. Commencez par 20 questions et un tableur. Le jour où le volume vous dépasse, automatisez, sans changer la méthode.
Questions fréquentes
Qu’est-ce qu’un audit GEO ?
C’est une analyse structurée de la présence d’une marque dans les réponses des IA : mentions, citations de votre site, concurrents cités, sources utilisées et erreurs de description. Il se conclut par un plan d’actions.
Combien de questions faut-il pour un audit GEO ?
Pour démarrer, 20 à 30 questions suffisent, posées au moins 3 fois par moteur. Les guides francophones vont de 10 à 15 requêtes pour un panel initial à 30 à 80 pour un panel utile. Plus vous avez de questions, plus l’estimation est stable.
Peut-on faire un audit GEO gratuitement ?
Oui, à la main : un tableur, des questions figées, des IA interrogées sans compte connecté. Côté outil, Vizioa offre 3 audits par mois aux agences.
Un audit GEO garantit-il d’être cité par ChatGPT ?
Non. Personne ne contrôle les réponses des moteurs. L’audit identifie les freins et les opportunités, il ne garantit pas de résultat.
Qu’est-ce que la présence spontanée dans un audit GEO ?
C’est la part des réponses qui citent la marque quand la question ne la nomme pas. C’est la visibilité auprès d’un prospect qui ne connaît pas encore votre nom. Dans l’exemple ci-dessus, elle est de 14 %, contre 43 % pour la présence globale.
Sources
- Pew Research Center, Google users are less likely to click on links when an AI summary appears in the results, 22 juillet 2025.
- SparkToro, New research: AIs are highly inconsistent when recommending brands or products, avec Gumshoe.ai, 28 janvier 2026.
- Google Search Central, AI features and your website, consultée le 30 septembre 2026.
- OpenAI, Overview of OpenAI Crawlers, consultée le 30 septembre 2026.
- Perplexity, Perplexity Crawlers, consultée le 30 septembre 2026.
- Wikipedia, Binomial proportion confidence interval (intervalle de Wilson).
- Cicero Studio, Méthodologie d’audit GEO en 8 étapes, consultée le 30 septembre 2026.
- Geoptim, Audit GEO, consultée le 30 septembre 2026.
- Vizioa, méthodologie, offre agences et tarifs.
- Exemple d’audit : audit Vizioa du 18 septembre 2026, anonymisé (9 questions, ChatGPT et Claude, 54 réponses). Intervalles de Wilson (z = 1,96) et test exact de Fisher calculés par nous à partir des effectifs du rapport. Tableau de l’étape 5 : chiffres fictifs d’illustration, intervalles calculés par nous.
À propos de l’auteur
Fondateur de Modernova Studio, expert GEO
Mouad Rifi a fondé Modernova Studio, l’éditeur de Vizioa. Il travaille sur la visibilité des marques dans les réponses des assistants IA : ce que ChatGPT, Gemini, Perplexity ou Google AI Overviews disent d’une entreprise, et comment le mesurer.